
把品牌形象图交给 wan3.0-video,一次生成带原生人声、口型同步的 15 秒口播成片。
说明
免责声明:本页展示内容均为 AI 模型生成,仅供参考,不构成任何效果承诺;实际产出效果与 Credits 消耗以控制台“用量详情”为准。本篇用一张虚构的橘猫主播形象图跑通品牌口播:没有真人出镜,也没有拍摄和后期配音,把“问候 → 产品 → 卖点 → 收尾”四句台词按顺序写进同一条提示词,模型一次生成约 15 秒、自带人声和口型同步的成片。
调用链:qwen3.8-flash(可选,整理口播台词)→ wan2.7-image(生成虚构角色形象图)→ wan3.0-video(first_frame 模式,duration 15,一次生成完整成片)。
实测产出
本次一次生成约 15 秒连续口播:四句台词逐字念出,音色、角色与画面(含茶叶罐)全程一致,成片不含“AI 生成”水印。台词就是成片实际念出的内容。
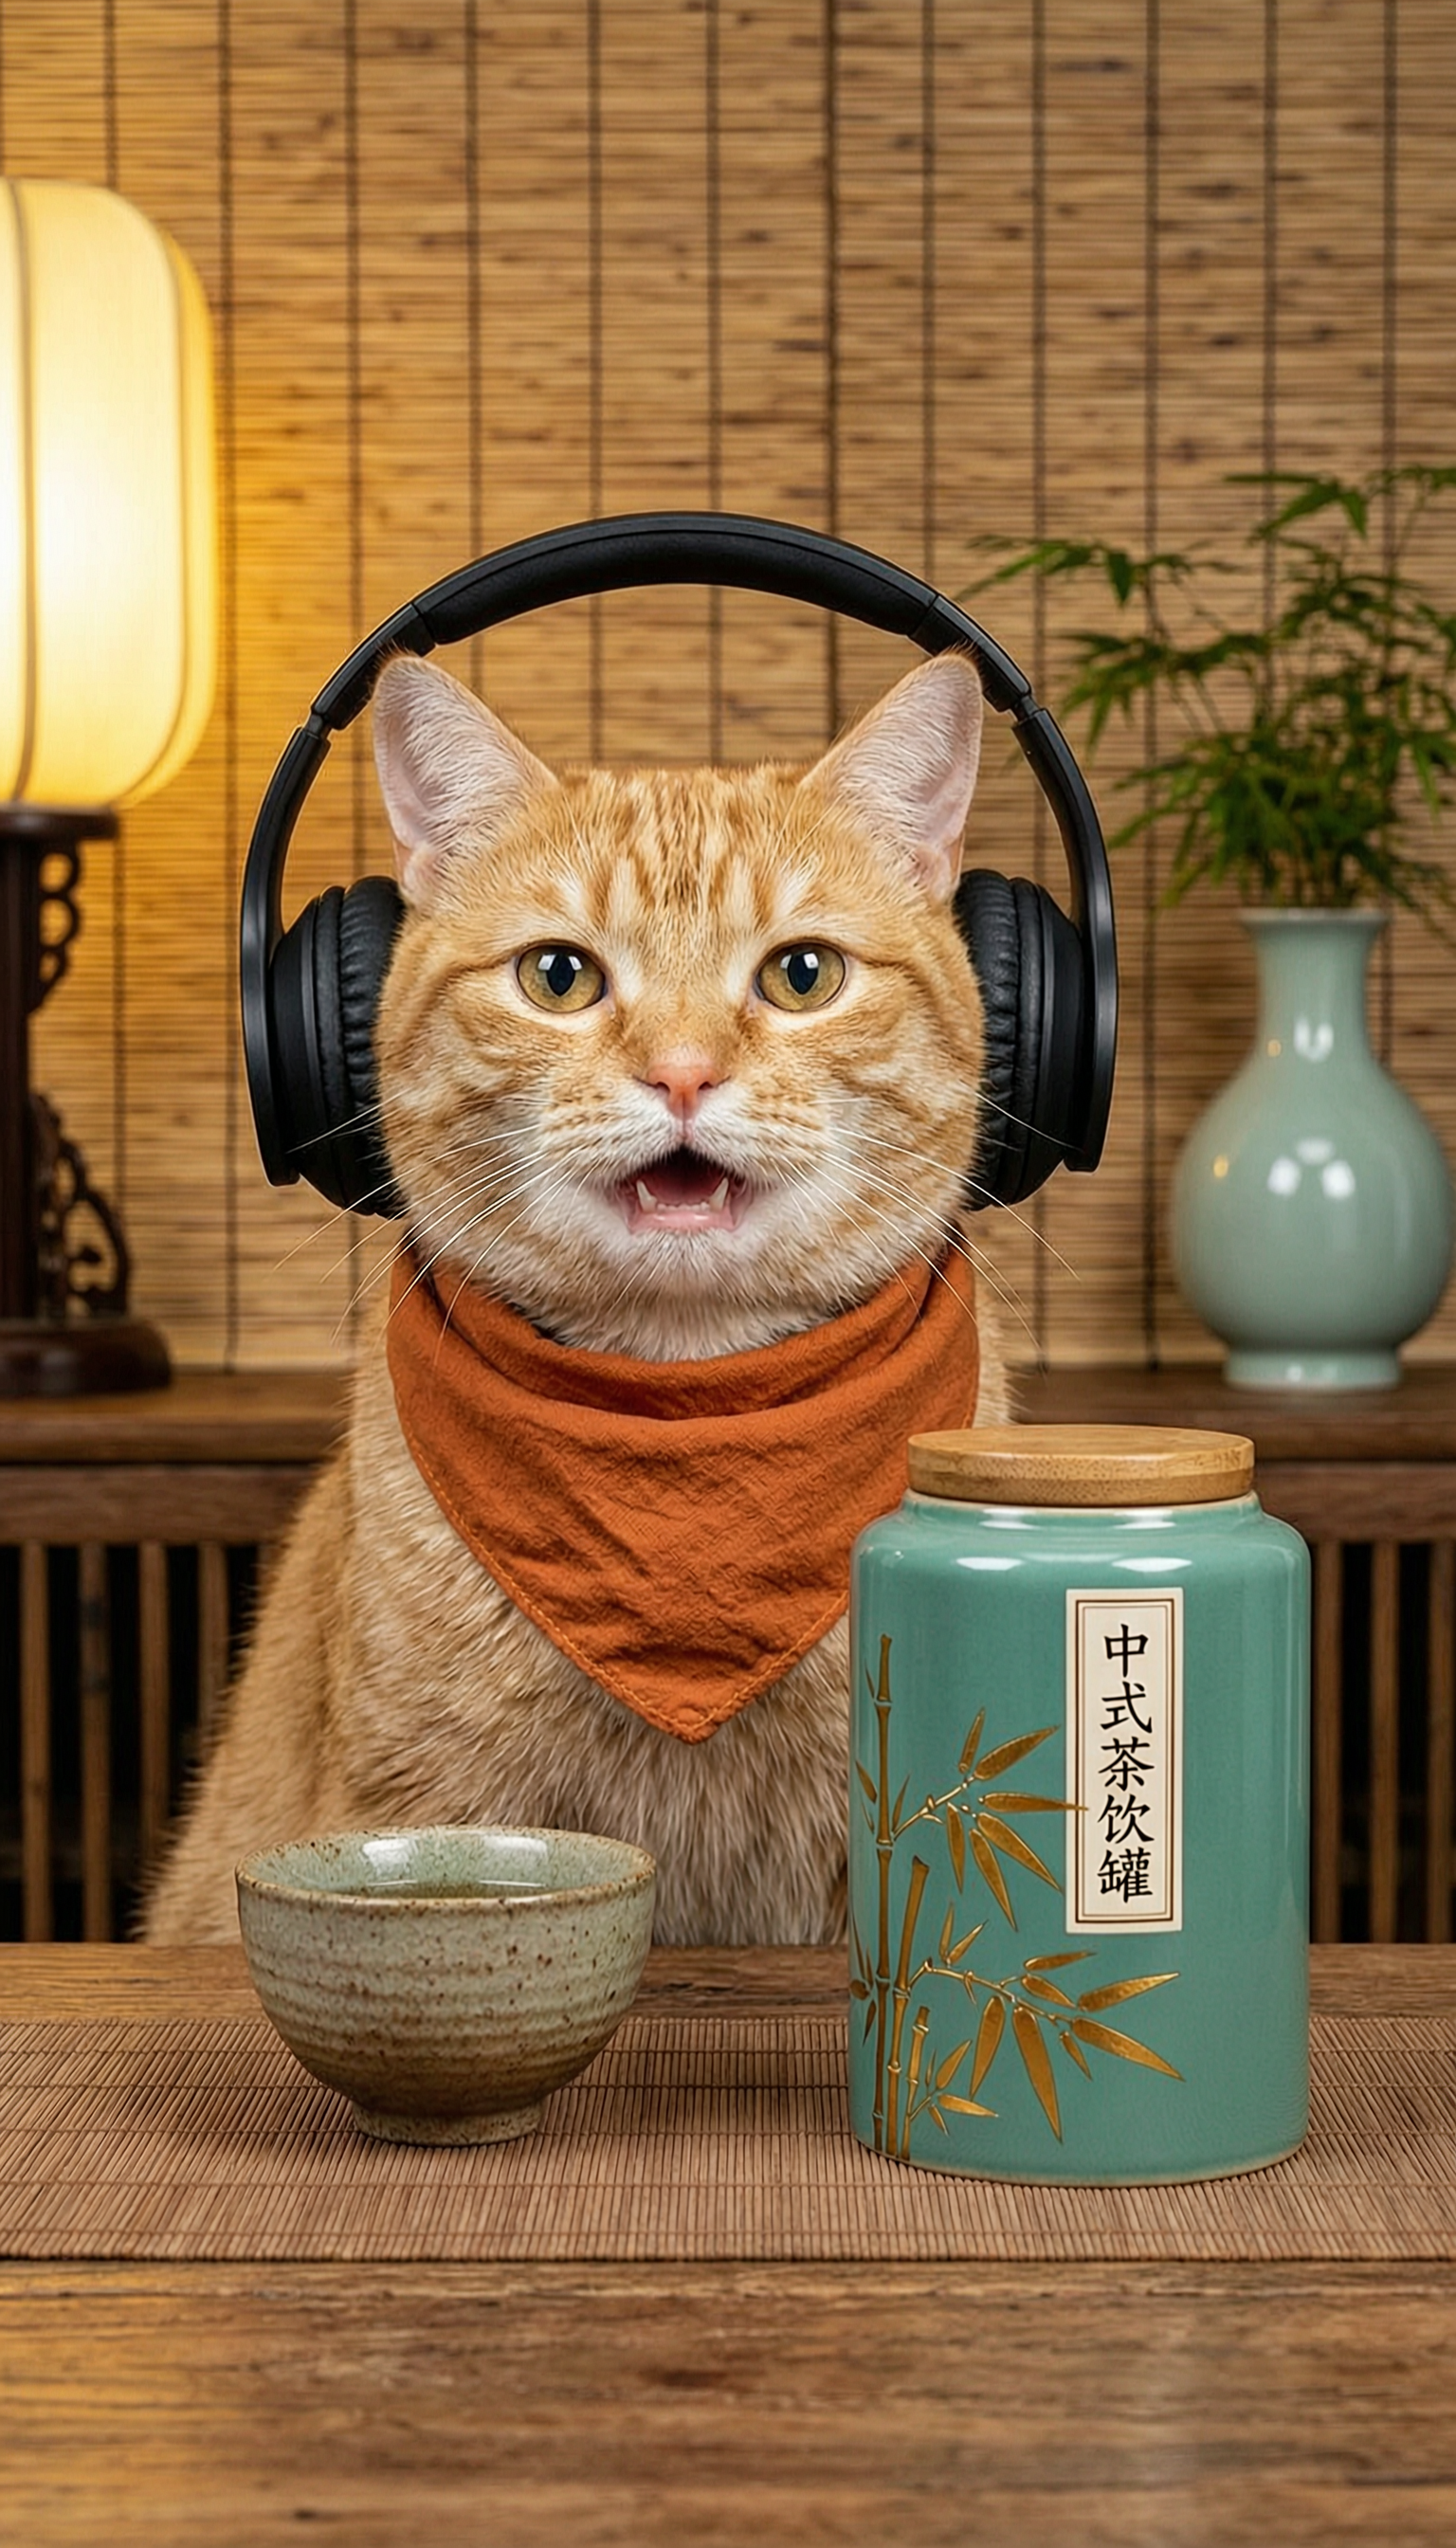
角色形象图同时画出橘猫主播与茶叶罐,作为成片的 first_frame 输入。成片以它为起帧,茶叶罐因此全程留在画面里,画面保持一致:
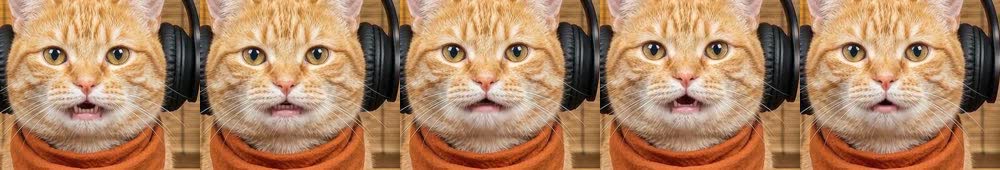
对成片连续抽帧可以看到口型变化:相邻帧里嘴部呈闭合、微张、大张的开合变化,与台词逐字对应,口型由模型原生驱动,不是后期配音。
步骤:把四句台词写进同一次生成
两点通用设置:出图和视频命令都加 --watermark false。首帧图若带“AI 生成”水印,会原样带进视频;图片和视频都关水印,成片才不会叠加图片水印。整段台词写进同一次 first_frame 生成,音色与画面天然统一,无需分段拼接。
先设置 Token Plan 的 Base URL 和 API Key。Token Plan 的 Key 以 sk-sp- 开头,需与 Token Plan Base URL 配套使用:
export BASE_URL="https://token-plan.cn-beijing.maas.aliyuncs.com"
export API_KEY="sk-sp-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"
①(可选)把卖点整理成口播台词
# 台词短、口语化、一句一个动作;避免"必爆/最强/第一"等绝对化表述与效果承诺。
bl text chat --api-key "$API_KEY" --base-url "$BASE_URL" --model qwen3.8-flash --message \
  "给一款虚构的中式绿茶茶叶罐写 3 句 15 字以内的口播台词,语气治愈、口语化,供虚拟主播逐字念白,不使用绝对化用语。"
② 造虚构角色形象图
# 角色形象图直接让「橘猫主播 + 茶罐」同框(完整成片以它作 first_frame 起帧,保证茶罐全程在画面里、画面统一)。
# 首帧图也要加 --watermark false:图片自带的「AI 生成」水印会原样带进成片。
bl image generate --api-key "$API_KEY" --base-url "$BASE_URL" --model wan2.7-image --size "1536*2688" --watermark false \
  --prompt "一只拟人化的橘猫品牌主播,戴着黑色头戴式耳机,脖子系暖橙色方巾,端坐在中式茶室的木质桌前正面朝向镜头;桌上右手边显眼地摆着一只青绿色陶瓷茶叶罐(罐身手绘金色竹叶纹样、木质罐盖、竖排中文标签『中式茶饮罐』),旁边一只粗陶茶杯;背景是竹帘与青瓷花瓶,暖黄灯光,写实治愈风格,正面半身构图,嘴微微张开" --out-dir . --out-prefix role_cat_host
③ 完整成片 · 一次生成串起四句口播
# 把「问候→产品→卖点→收尾」四句按顺序写进同一条 first_frame prompt、duration 15,一次即产出音色/画面(含茶罐)全程统一的连续口播,无需分段拼接。
# 口型需在 prompt 中明确约束:台词逐字写入并加「嘴唇和下巴要有清晰明显的开合动作」;仅写表情(如「兴奋地喊」)会得到闭口静止的画面。
# --watermark false 关闭视频模型水印;首帧图已用同一参数生成,成片不会带入图片水印。
bl video generate --api-key "$API_KEY" --base-url "$BASE_URL" --model wan3.0-video \
  --image ./role_cat_host.png --resolution 720P --duration 15 --watermark false \
  --prompt "戴耳机的橘猫主播坐在中式茶室的木桌前,桌上右手边摆着青绿色茶叶罐,正面朝向镜头,自然地依次逐字说出下面这四句中文台词,每句说完停顿约半秒再说下一句,不要重叠:第一句“忙了一整天,先喝口热的吧。”第二句“这罐明前龙井,锁住了整个春天。”第三句“掀开木盖,豆香混着栗香一下就钻进鼻子里。”第四句“累了就泡一壶,给自己留一段慢下来的时间。”嘴部和下巴要有清晰明显的开合动作,说话时轻微眨眼、头部自然晃动,茶罐与角色形象全程保持一致。暖黄灯光,治愈系实拍质感,固定机位中近景。" \
  --download g_full.mp4
# 15s 长片段建议加 --async --output json 先取 task_id,再轮询 GET $BASE_URL/api/v1/tasks/{task_id} 到 SUCCEEDED 后从 output.video_url 下载,避免默认轮询超时。
# 一条成片即含四句连念、音色画面全程统一;若只需某一句,直接从 g_full.mp4 按时间轴截取片段即可,无需另行生成。
说明
- 消耗:本玩法最多三次调用:文本(
qwen3.8-flash)1 次、出图(wan2.7-image)1 次、视频(wan3.0-video)1 次。视频消耗明显高于文本和出图;15 秒长片段建议使用异步任务:先提交取 task_id,再轮询查询到 SUCCEEDED 后下载,避免长时间轮询超时。实际 Credits 消耗以控制台“用量统计”为准。 - 一次生成:四句台词放在同一次 first_frame 生成里,音色、角色和画面天然统一,不需要分段拼接,也没有接缝。口型是否明显,取决于提示词里有没有写清嘴唇和下巴的开合动作。
- 首帧:角色和产品画在同一张形象图里,产品才能全程留在画面中。换真实品牌时,把形象图换成已授权的素材,产品可以一并画进首帧,台词换成合规文案。
- 合规:演示中的角色、茶叶罐和台词均为虚构,不含真人肖像、真人录音和第三方商标。本页首帧图和视频均按
--watermark false生成,成片不含“AI 生成”水印;需要保留该标识时,出图和视频都省略此参数(使用 Profile 配置,CLI 默认 true)或传--watermark true。对外发布 AI 生成内容时,请遵守适用的 AI 生成内容标识要求;本页关闭水印仅用于演示素材制作。
该文章对您有帮助吗?