
把零散心里话润色成信、念成语音、配上会动的分镜,合成一支短片。
说明
免责声明:本页展示内容均为 AI 模型生成,仅供参考,不构成任何效果承诺;实际产出效果与 Credits 消耗以控制台「用量详情」为准。本篇以一段写给妈妈的口语心里话跑通全链路,合成一支 23 秒、自带女声朗读和逐句字幕的短片。有些话当面说不出口、打字又太干,想对异地的爸妈、爱人、孩子说声想念或生日快乐,就把零散心里话交给模型润色、配音、配画面,做成一支能直接发过去的影像信。
调用链:qwen3.8-max(润色成信)→ qwen-audio-3.0-tts-plus(念成语音)→ wan2.7-image(出 5 张分镜图)+ happyhorse-1.1-i2v(每张变 5 秒画面)→ 本地 ffmpeg 合成(不耗 Credits)。
实测产出
合成的 23 秒成片(5 个分镜跟着句子换画面,自带女声朗读 + 逐句字幕,记得开声音):
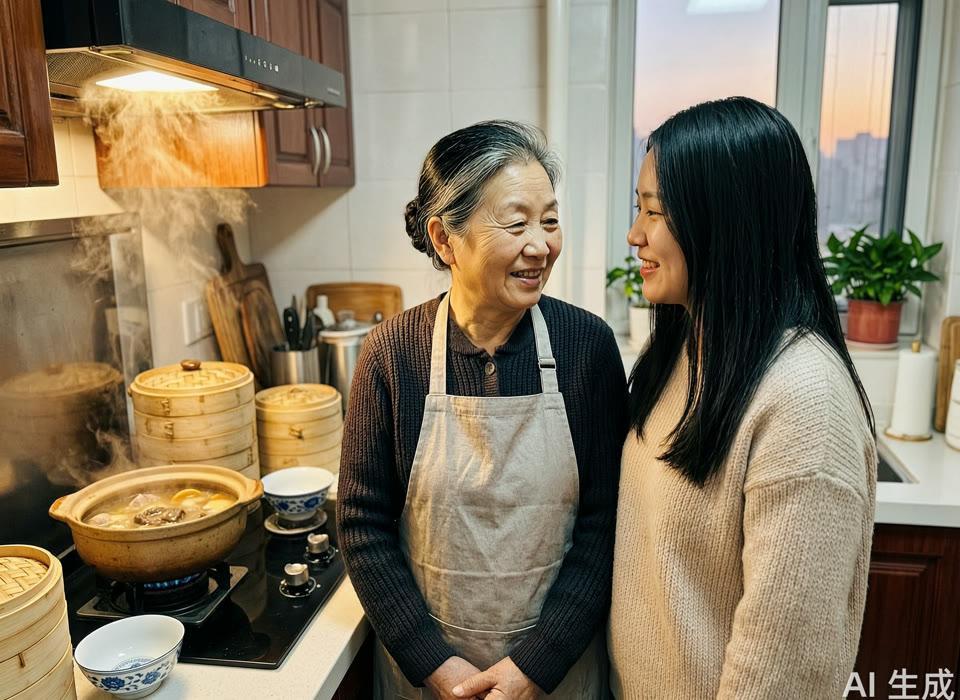
起点素材是 wan2.7-image 生成的分镜图之一(真做时换成你和家人的真实合照):
步骤:把心里话润色成一封能读出来的信
先把口语心里话发给 qwen3.8-max 润色成信:
帮我把下面这段口语、零散的心里话,润色成一封温暖、真诚、可以读出来的信。写给我妈妈。
要求:
1. 保留我说的所有真实细节(饺子、唠叨多穿点、异地三年、生日),不要编我没说过的事
2. 口语化、像真人在说,不要华丽辞藻和排比堆砌,宁可朴素
3. 控制在 200 字以内,因为要念成语音,太长听着累
4. 结尾落到"生日快乐"和一句最想说的话
5. 只输出信的正文
我的心里话:【粘贴你想对家人说的话,说得零散、口语没关系】
信润色好后,用 qwen-audio-3.0-tts-plus 念成语音、wan2.7-image + happyhorse-1.1-i2v 出分镜,最后本地 ffmpeg 按字幕时间轴顺接、混音、加字幕。
查看实测产出 · 润色后的信(qwen3.8-max 原文)
妈,我在外地工作三年了,一年也就回去一两次。每次视频,你都说家里都好,
让我别惦记,可我知道你一个人。其实我很想你。你包的饺子,你唠叨我多穿点,
我都记得。谢谢你。你生日快到了,生日快乐。我最想说的是:妈,我爱你。

(输入只是一段零散口语:"我不太会表达…在外地三年…她包的饺子、唠叨我多穿点
我都记得…妈生日快到了想说声谢谢和生日快乐"。模型保留了全部真实细节、
没有编造,压到 105 字、口语、适合念出来。)
说明
- 消耗:本玩法把三种模态串起来,文本(
qwen3.8-max)1 次 → 语音(qwen-audio-3.0-tts-plus)1 次 → 出图(wan2.7-image)5 次 + 图生视频(happyhorse-1.1-i2v)5 次。视频生成消耗明显高于文本和语音,分镜越多越贵,且异步任务完成后统一结算,先用 5 秒、720P 跑通一个分镜再补齐其余。合片(对齐时长、加字幕、混音)用本地 ffmpeg 完成,不耗 Credits。 - 怎么把零件拼成一支片子:TTS 语音 23.5 秒,而 i2v 一次只出 5 秒。别用一段素材正放倒放循环铺满全程,画面会明显重复,还跟正在念的句子对不上。做法是按字幕分镜:先把信切成 7 句、依字数比例排出时间轴,再让每 1–2 句配一个分镜(异地窗前的女儿 → 母亲一个人视频通话 → 包饺子的手 → 生日的蜡烛 → 母女相视而笑),最后本地用 ffmpeg 把 5 段素材按时间轴顺接(时长不够的那段轻微慢放补足)→ 混入语音 → 叠逐句字幕 → 首尾淡入淡出。剪辑在本机完成,不消耗 Credits。
- 出图:出图提示词里要把人写清楚,只写「母亲和女儿」,模型很容易给出欧美面孔;把「中国母女、东亚面孔、中式厨房(砂锅/蒸笼/青花瓷碗)」写进提示词,再用反向提示词排除「欧美面孔」,出来的合照才像自家人。
- 音色:
qwen-audio-3.0-tts-plus没有内置系统音色,要用克隆或音色设计接口先建一个音色 ID 再传入;想开箱即用系统音色可改cosyvoice-v3-flash(如longanyang,已实测直接出音)。想要更长的片子就让信写长一些,字幕时间轴会自动跟着摊开。 - 隐私:真做时用你和家人的真实合照替换演示图(i2v 直接吃你的照片);照片属于隐私,注意只在自己可控的环境里处理。
该文章对您有帮助吗?