
多模态交互开发套件支持声音复刻及声音设计能力。本文档旨在通过操作指南,帮助开发者或用户快速上手并高效完成此类功能的实践。
声音复刻
声音复刻(Voice Cloning)只需您提供一段 10~20 秒的音频样本,即可生成高度相似的定制音色,无需模型训练。
支持的模型
目前支持声音复刻的语音合成模型有:
- CosyVoice系列:CosyVoice-v3.5-Plus大模型、CosyVoice-v3.5-Flash大模型、CosyVoice-v3-Plus大模型、CosyVoice-v3-Flash大模型、CosyVoice-v2大模型。
- Qwen系列:千问3-TTS-声音复刻。
其中CosyVoice系列模型创建音色免费,Qwen系列模型按 0.01 元/个 计费,创建失败不计费。
操作步骤
重要控制台中需选中以上其中一个语音合成模型才可进行后续声音复刻操作。
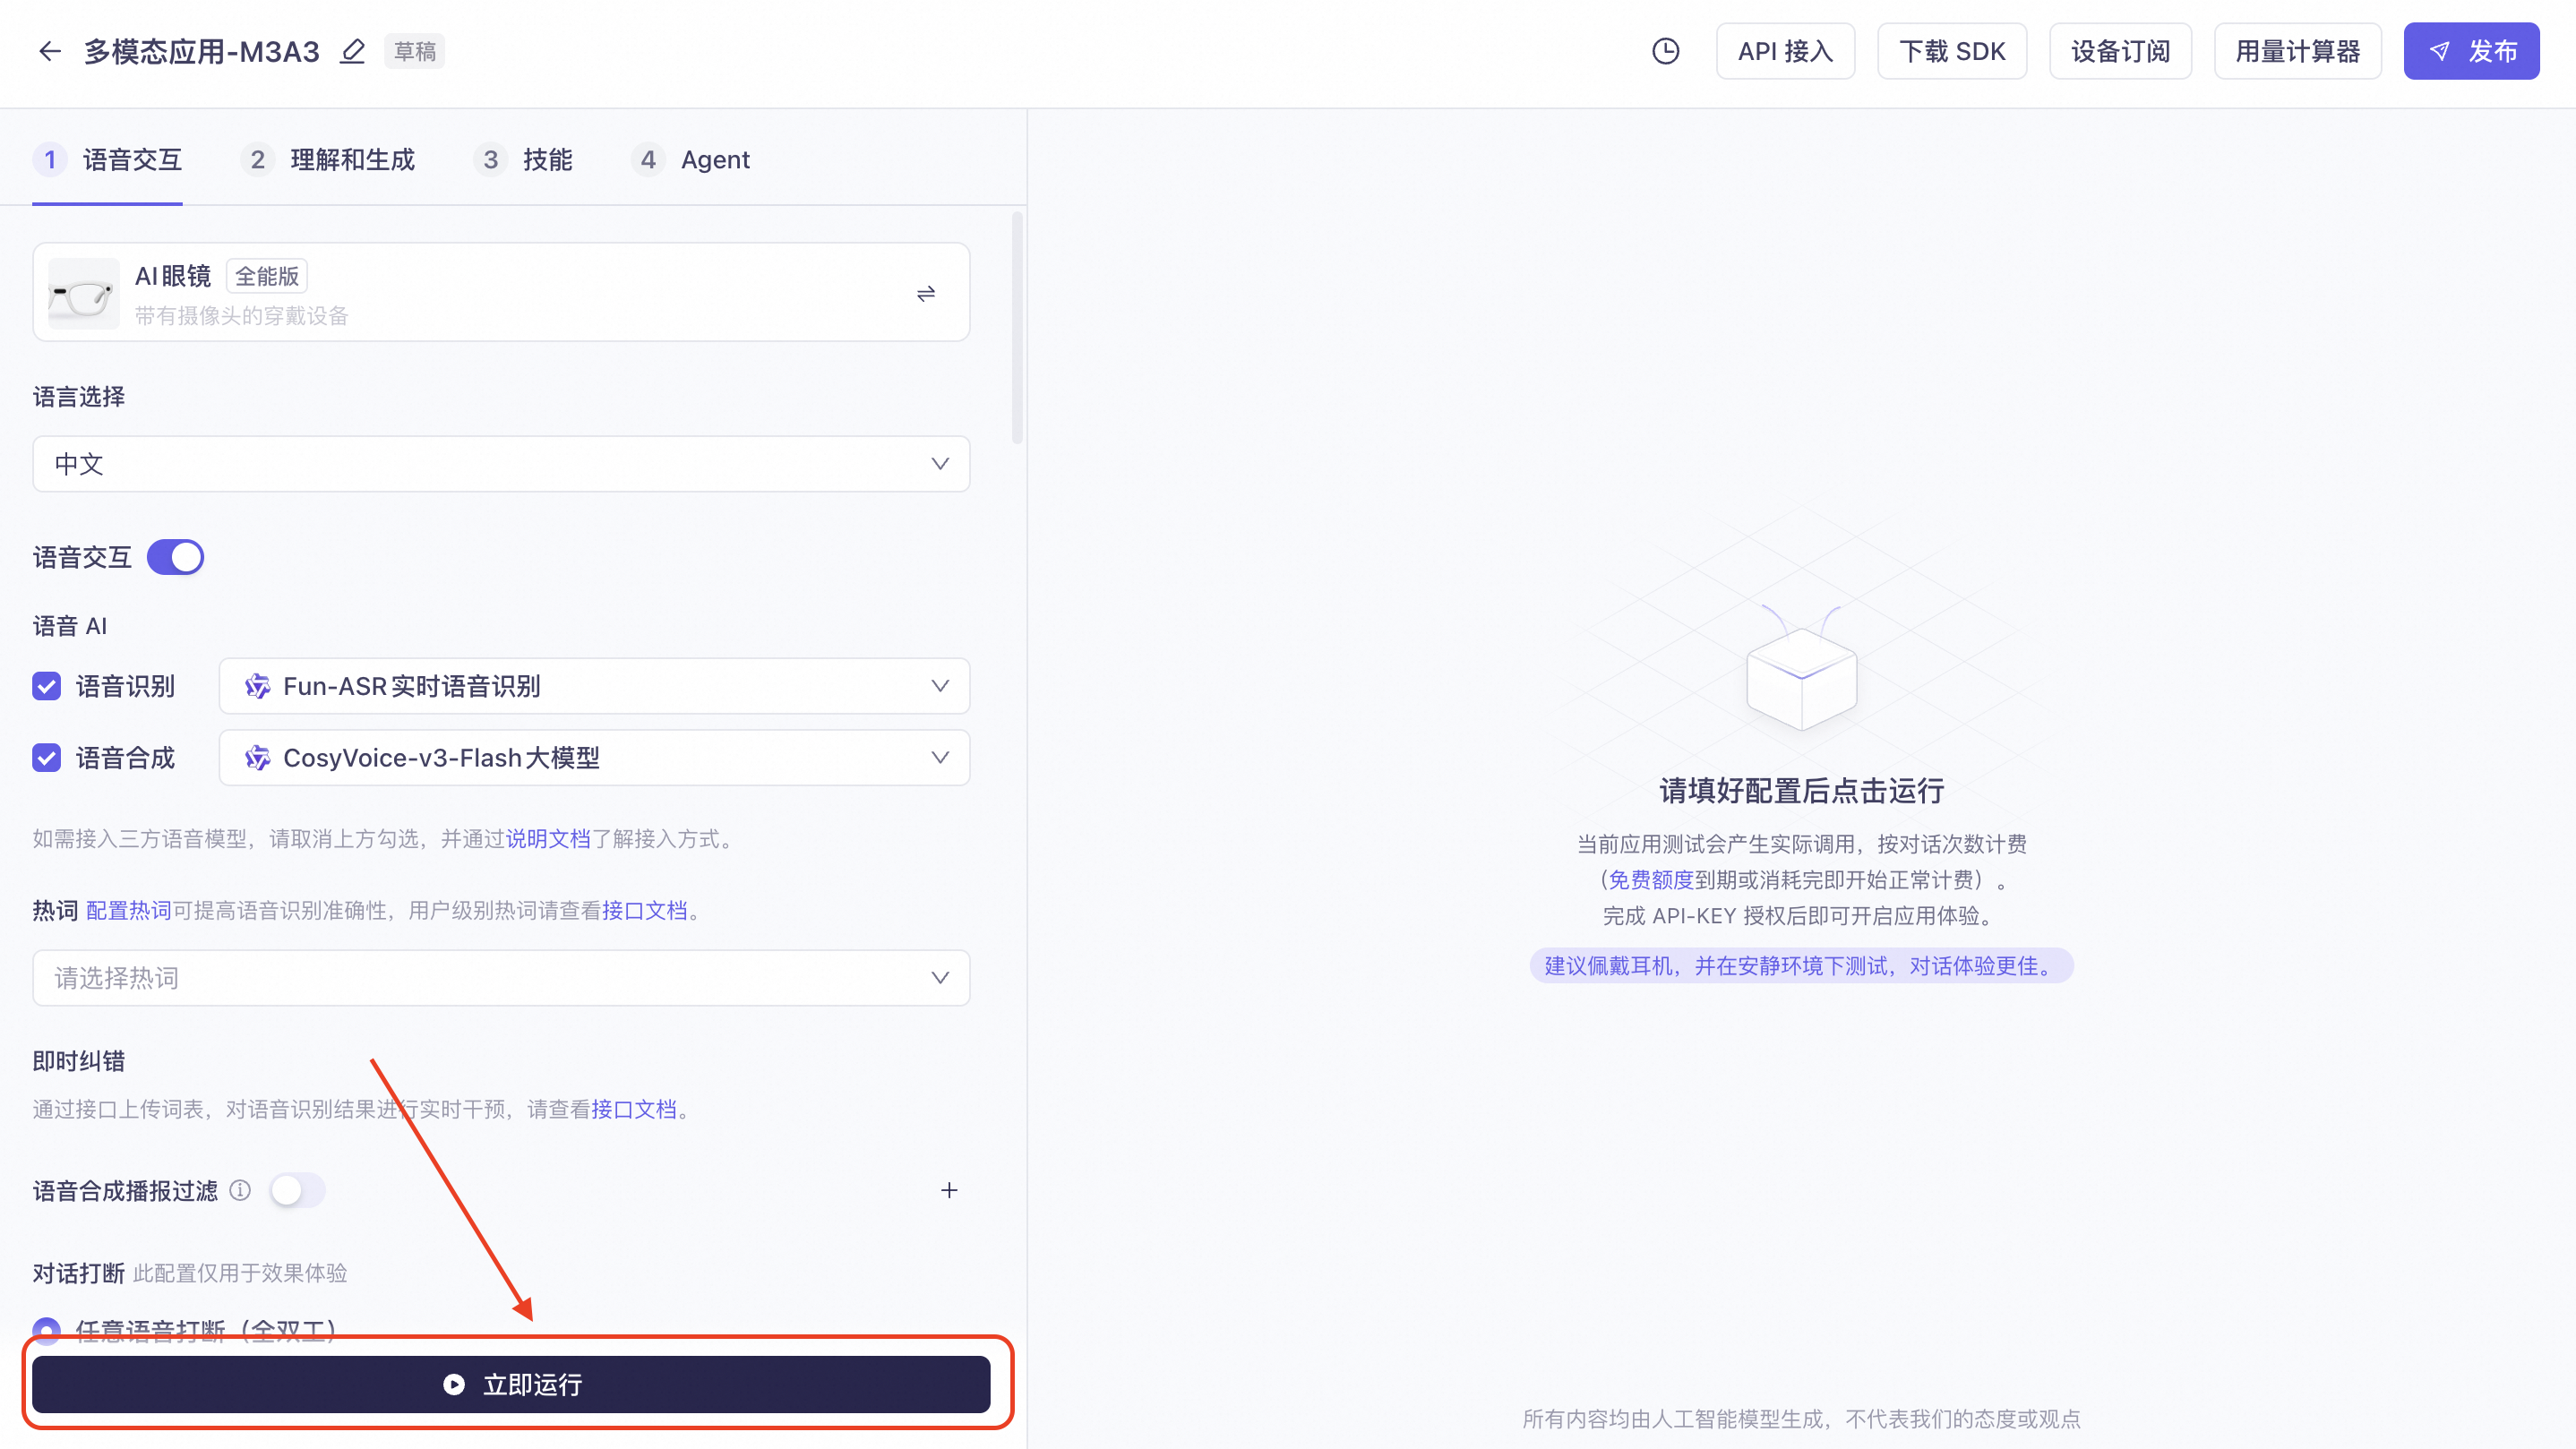
在控制台填好左侧配置项后,您可以点击「立即运行」并完成API-KEY授权。
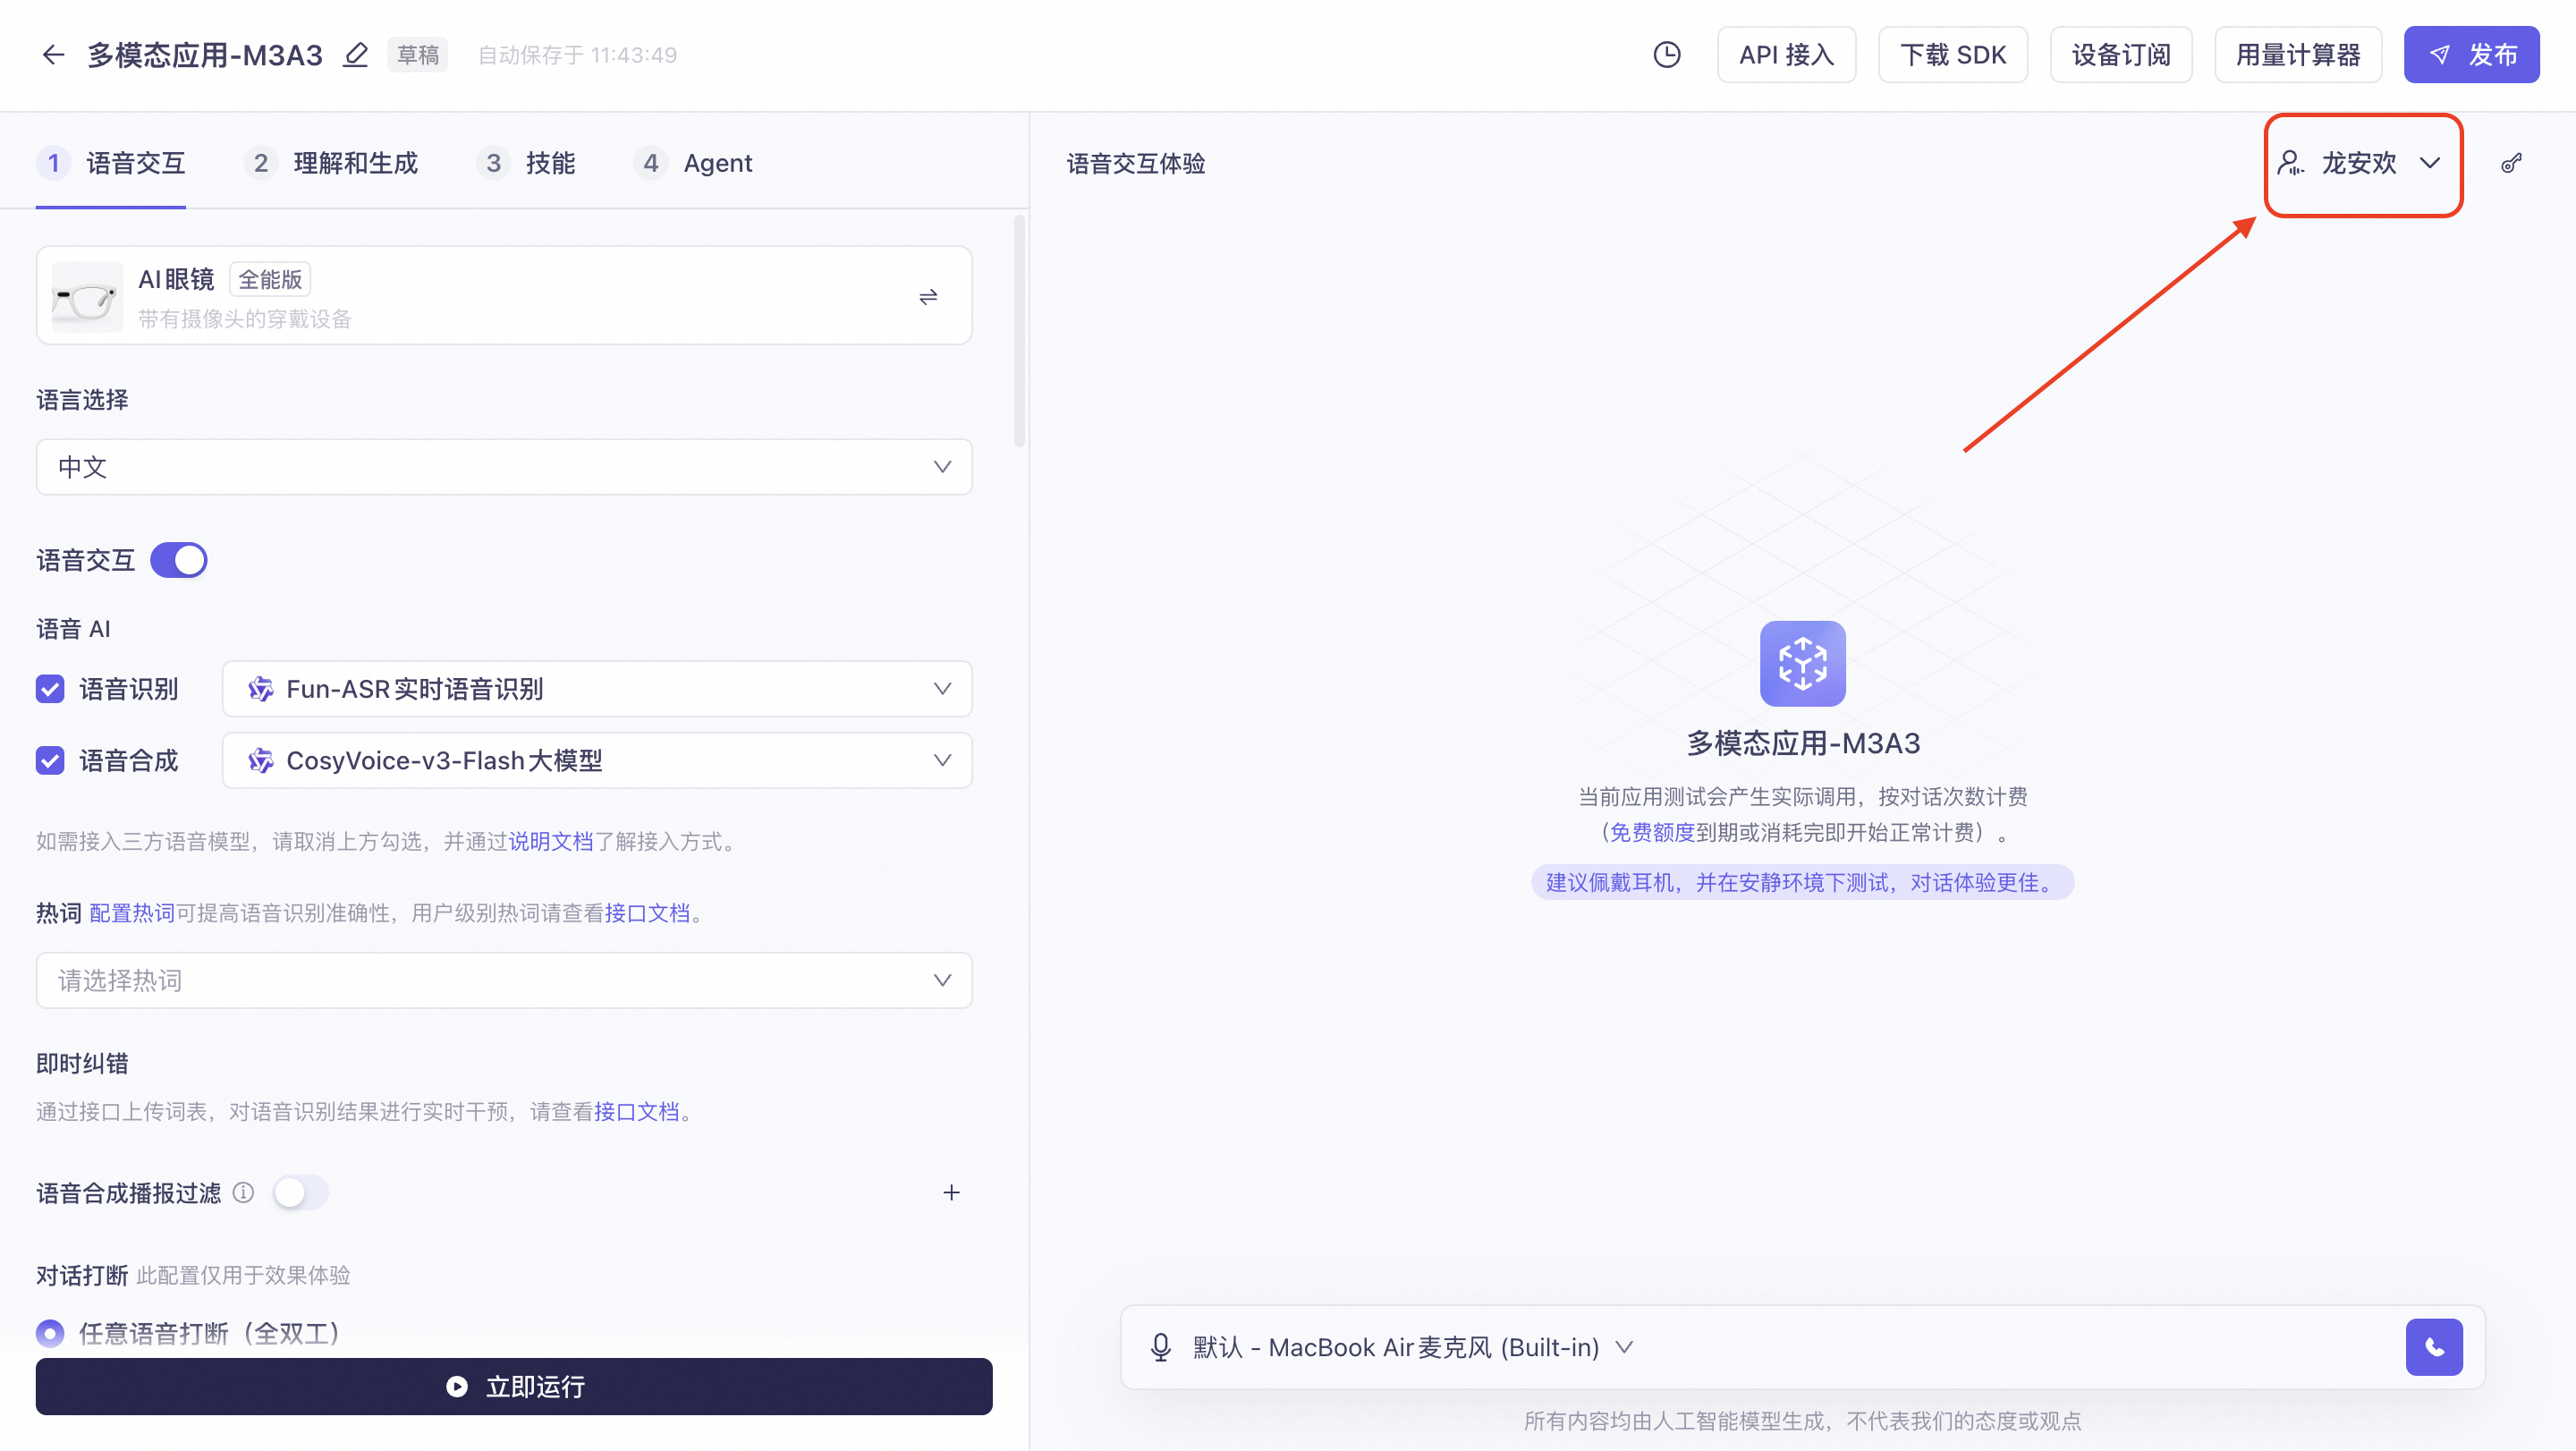
授权完成后,您可以点击应用体验区右上角的音色名称,在展开的面板中点击「复刻音色」进行操作。
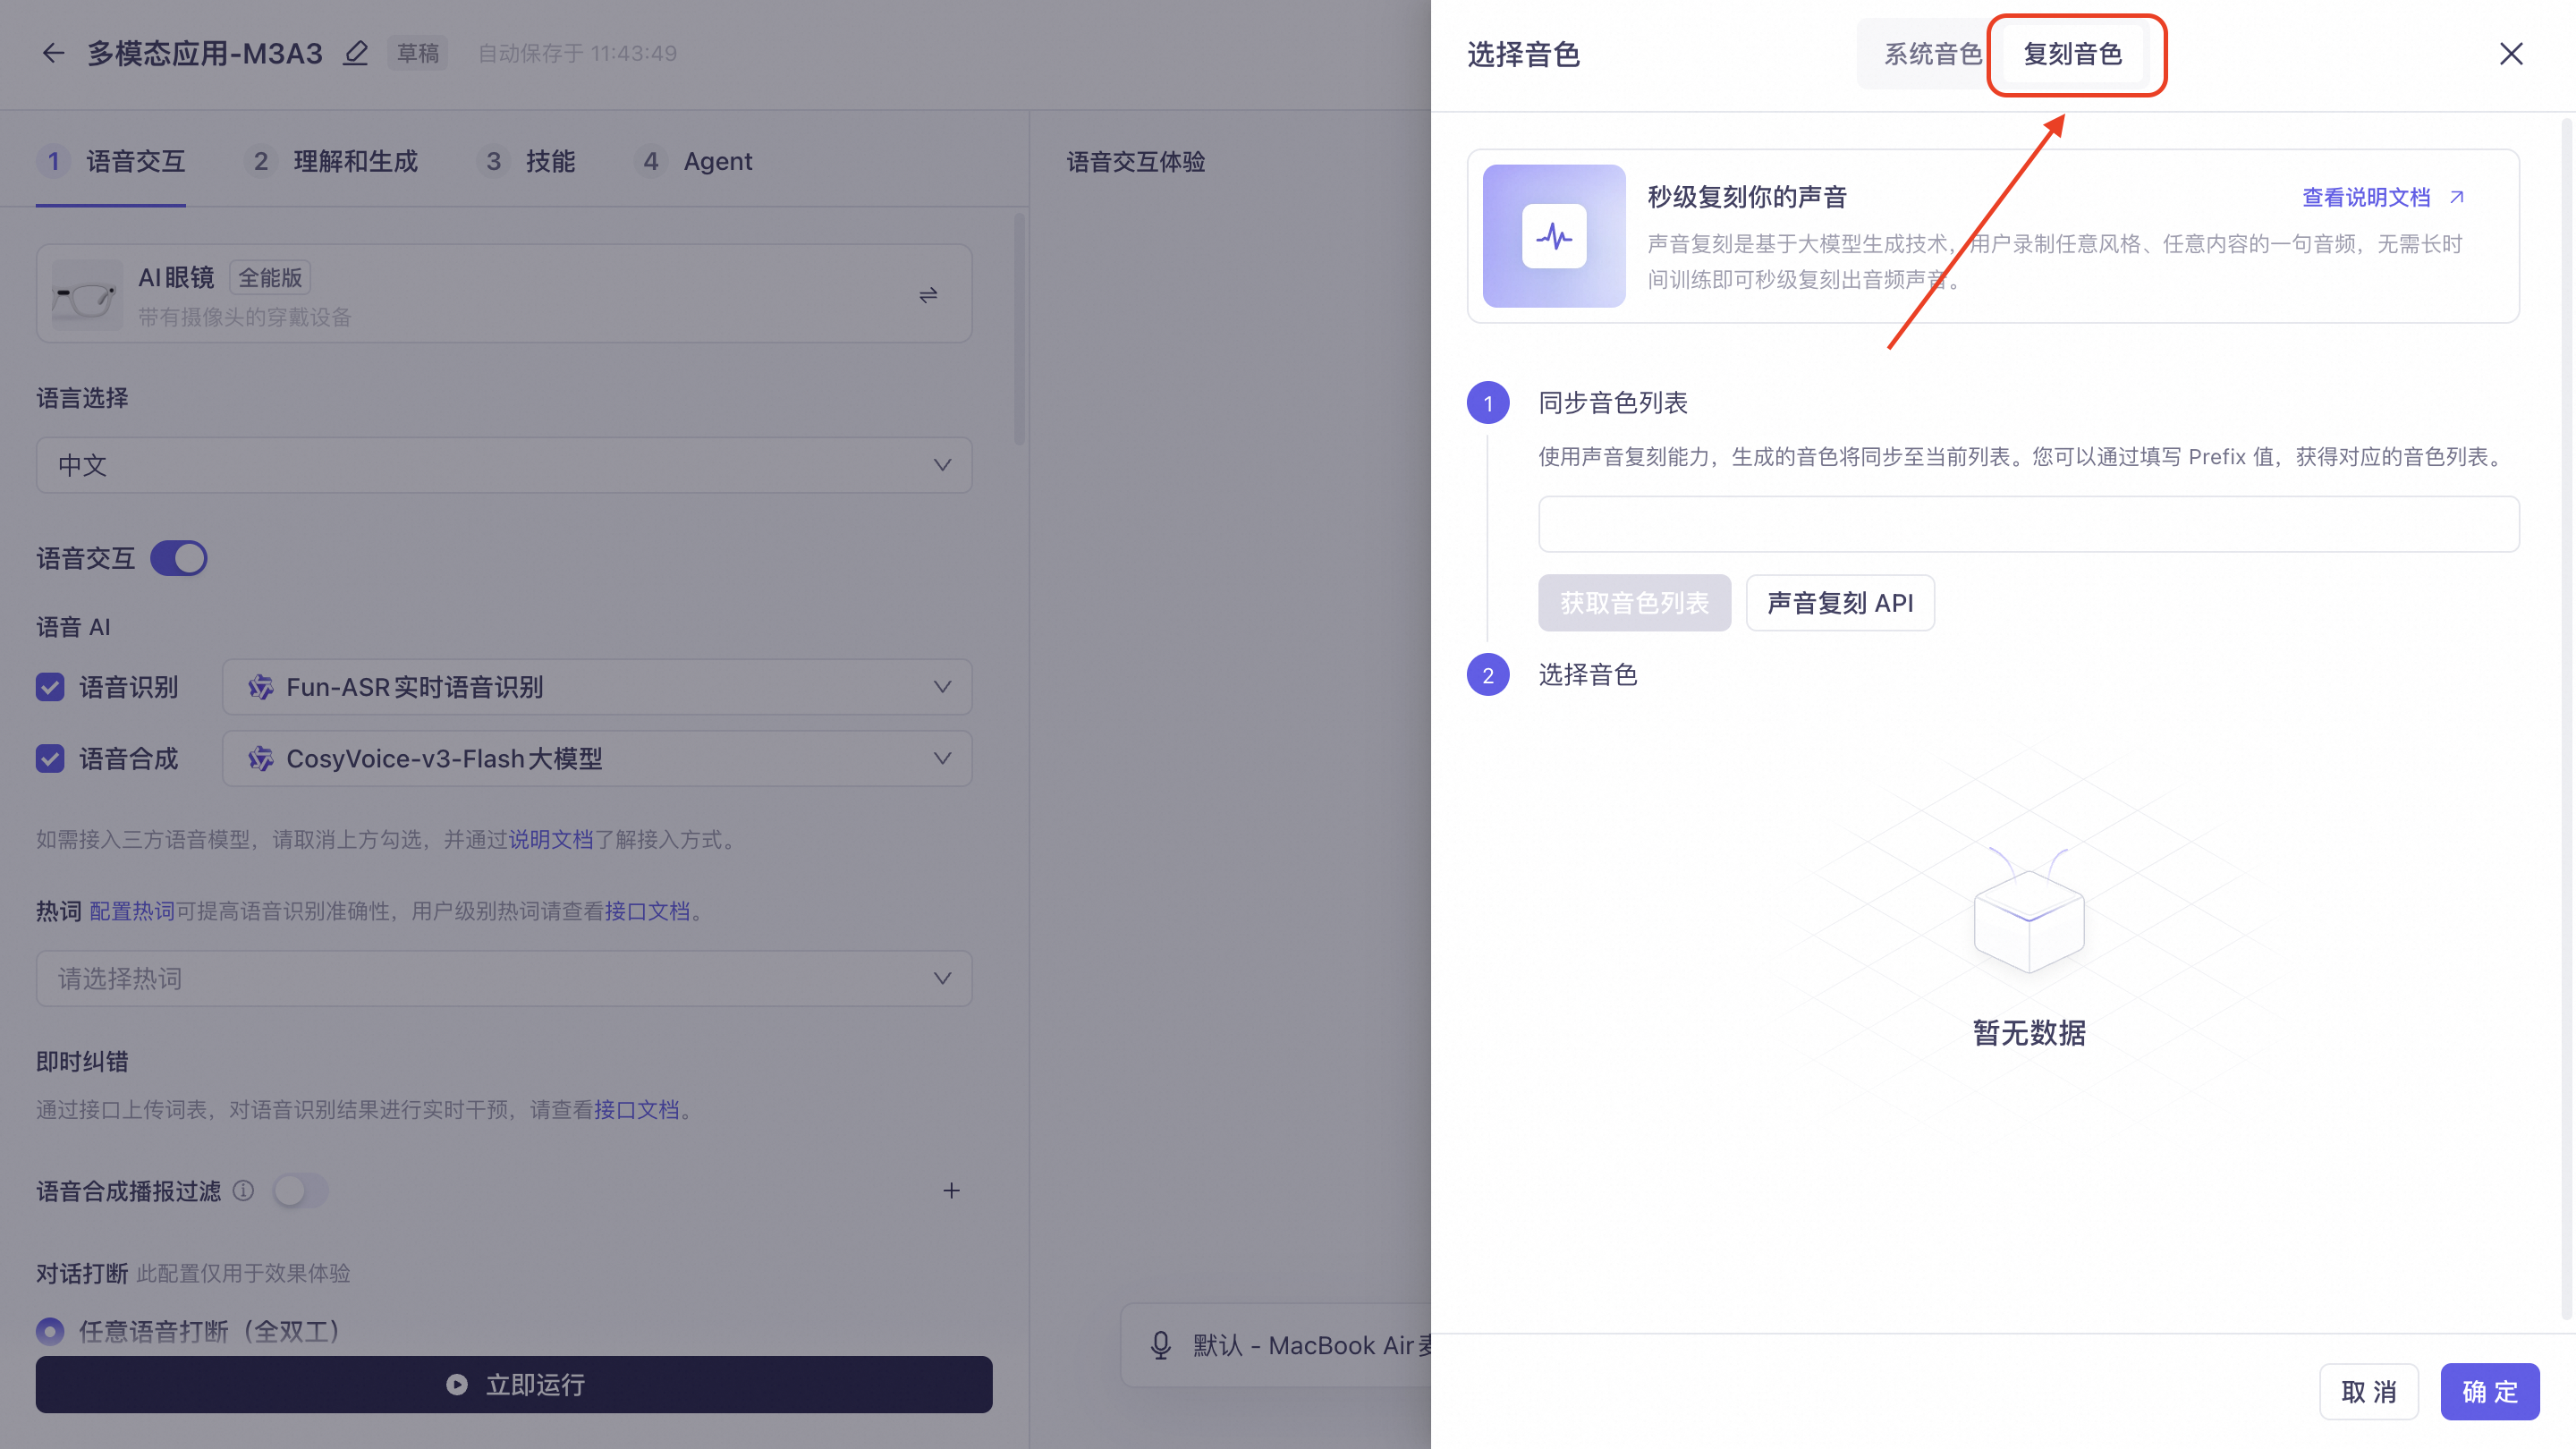
使用声音复刻能力,生成的音色将会同步至当前列表,您可以通过填写Prefix值获取对应音色列表,然后选择需要的音色点击「确定」即可。
说明同步音色列表前,您需要先创建音色列表,参考声音复刻文档。
声音设计
声音设计(Voice Design)无需音频样本,您可以仅通过自然语言描述创建定制化音色。
支持的模型
目前支持声音设计的语音合成模型有:
- CosyVoice系列:CosyVoice-v3.5-Plus大模型、CosyVoice-v3.5-Flash大模型。
- Qwen系列:千问3-TTS-声音设计。
其中CosyVoice系列模型创建音色免费,Qwen系列模型按 0.2 元/个计费,创建失败不计费。
操作步骤
重要控制台中需选中以上其中一个语音合成模型才可进行后续声音设计操作。
与声音复刻的操作步骤一致,唯一的区别在于音色列表是通过声音设计而生成的。
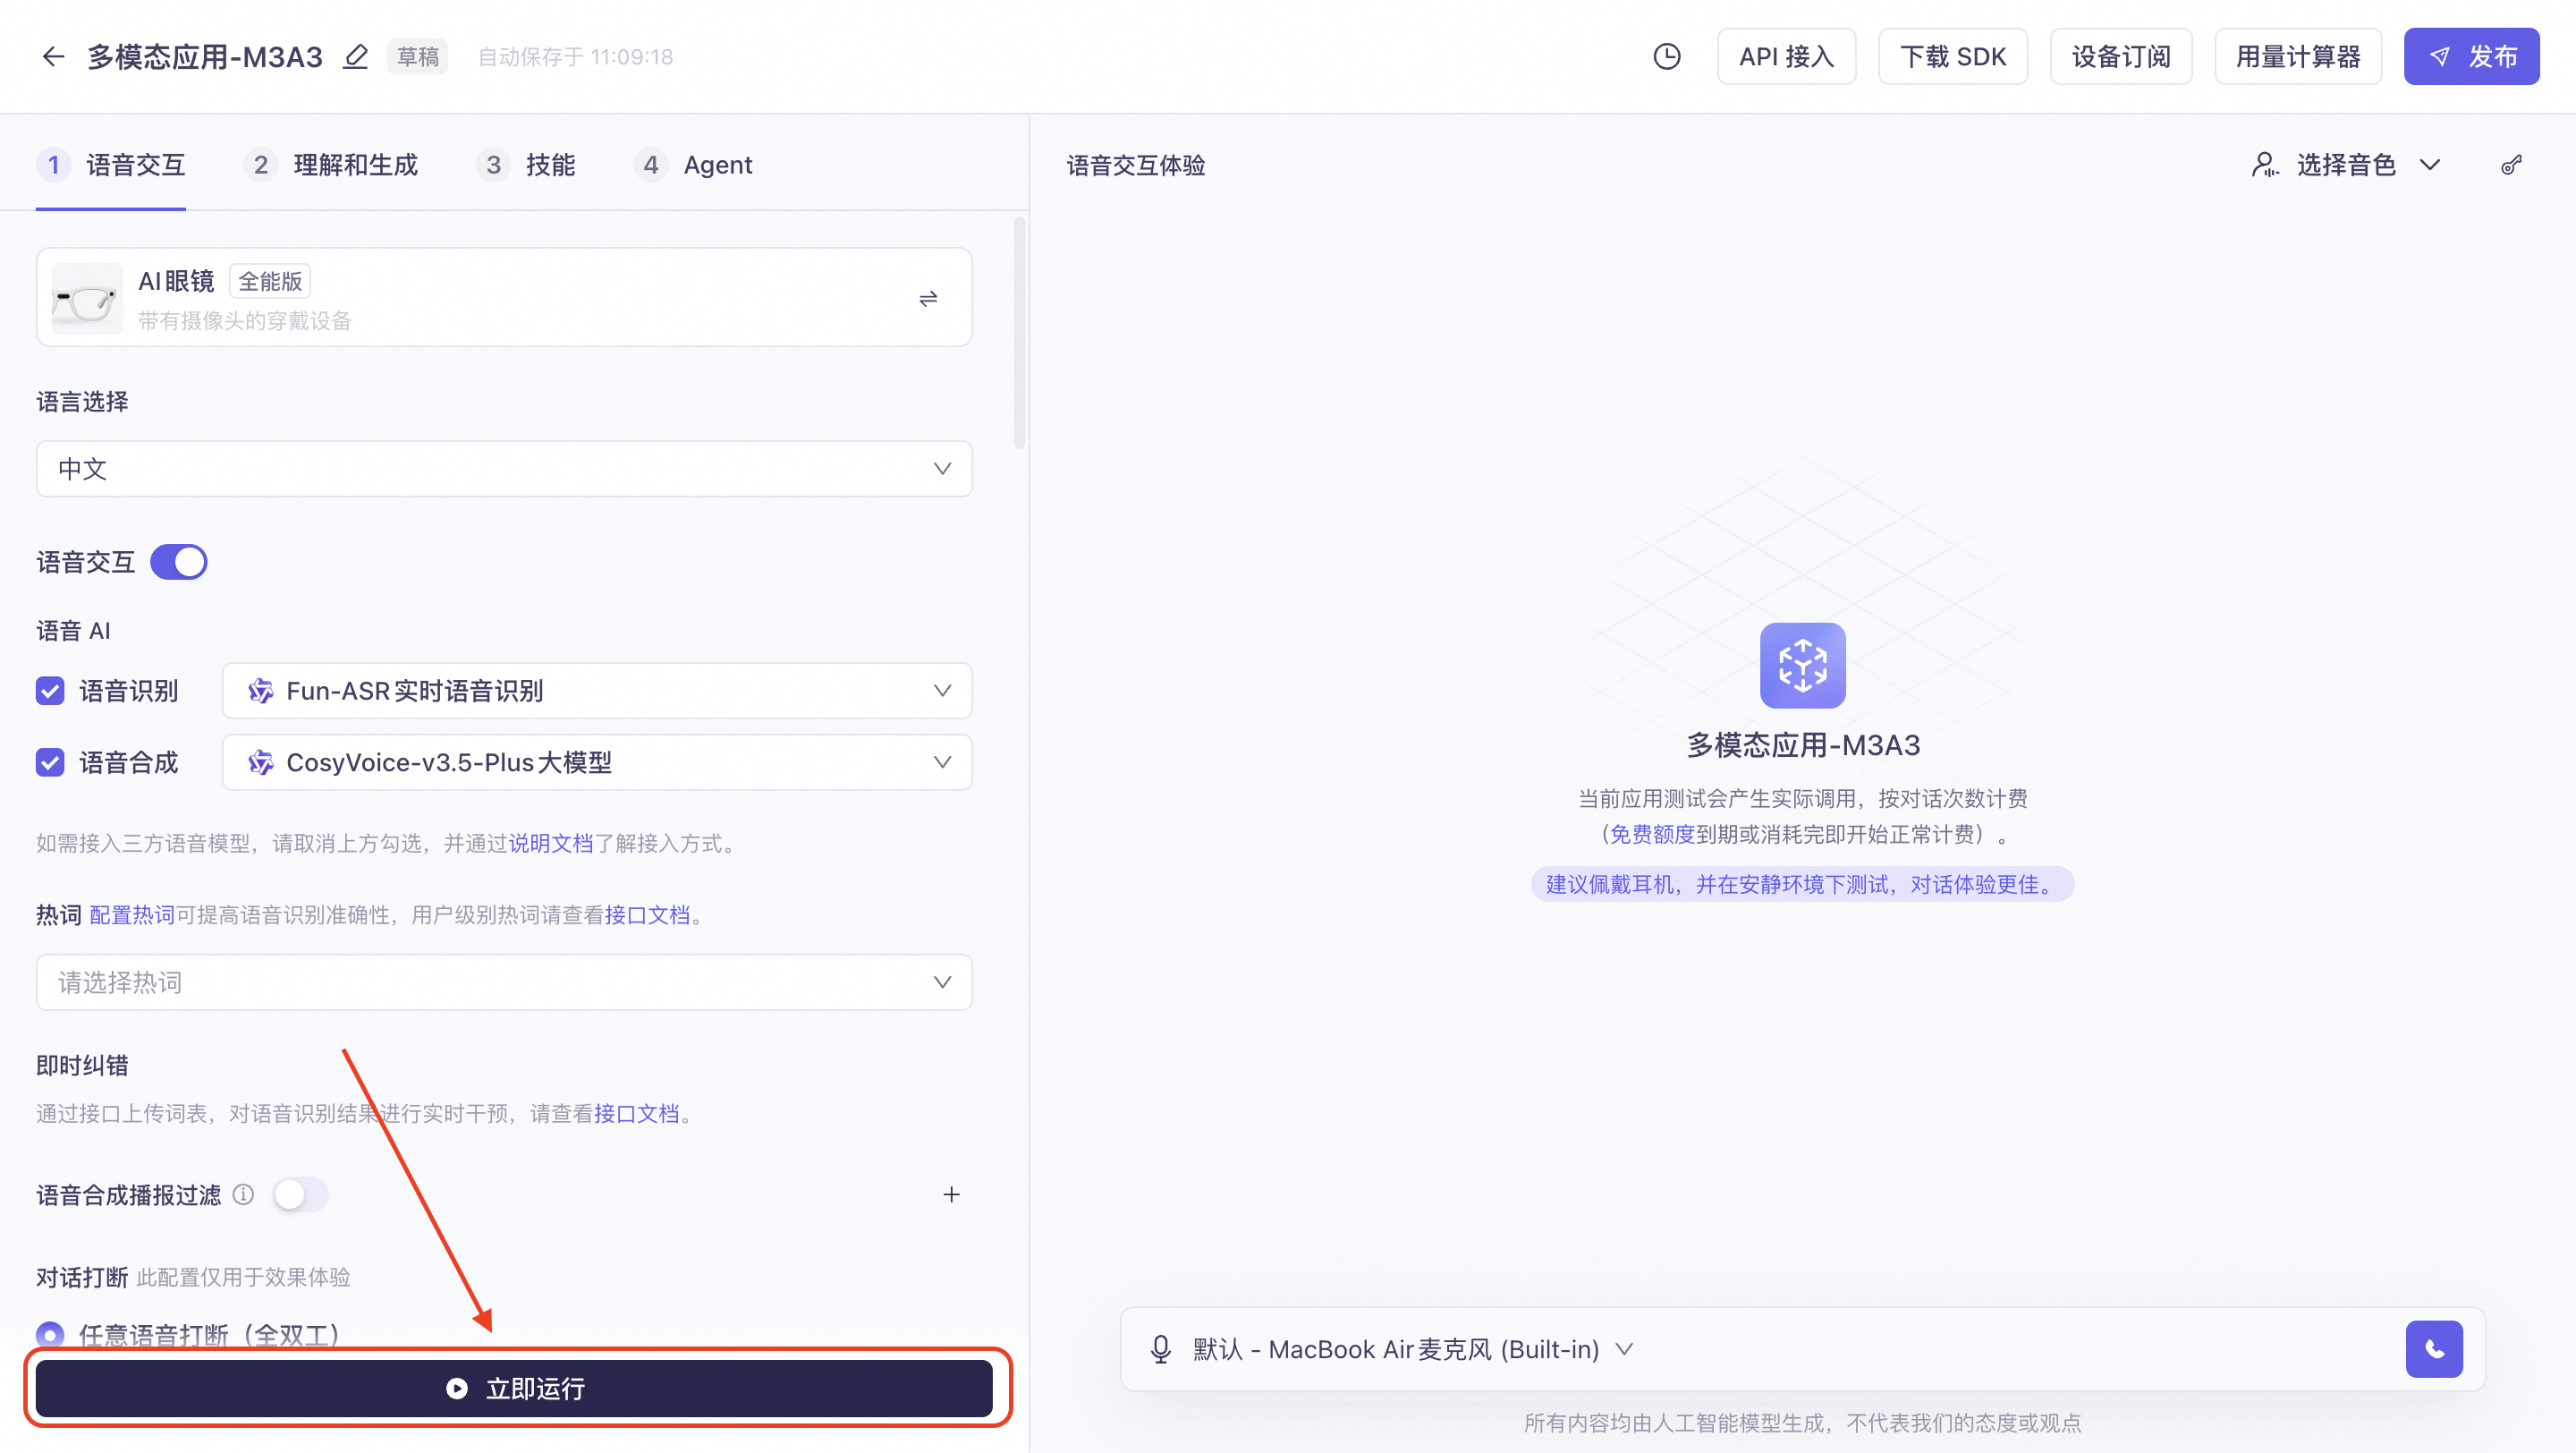
在控制台填好左侧配置项后,您可以点击「立即运行」并完成API-KEY授权。
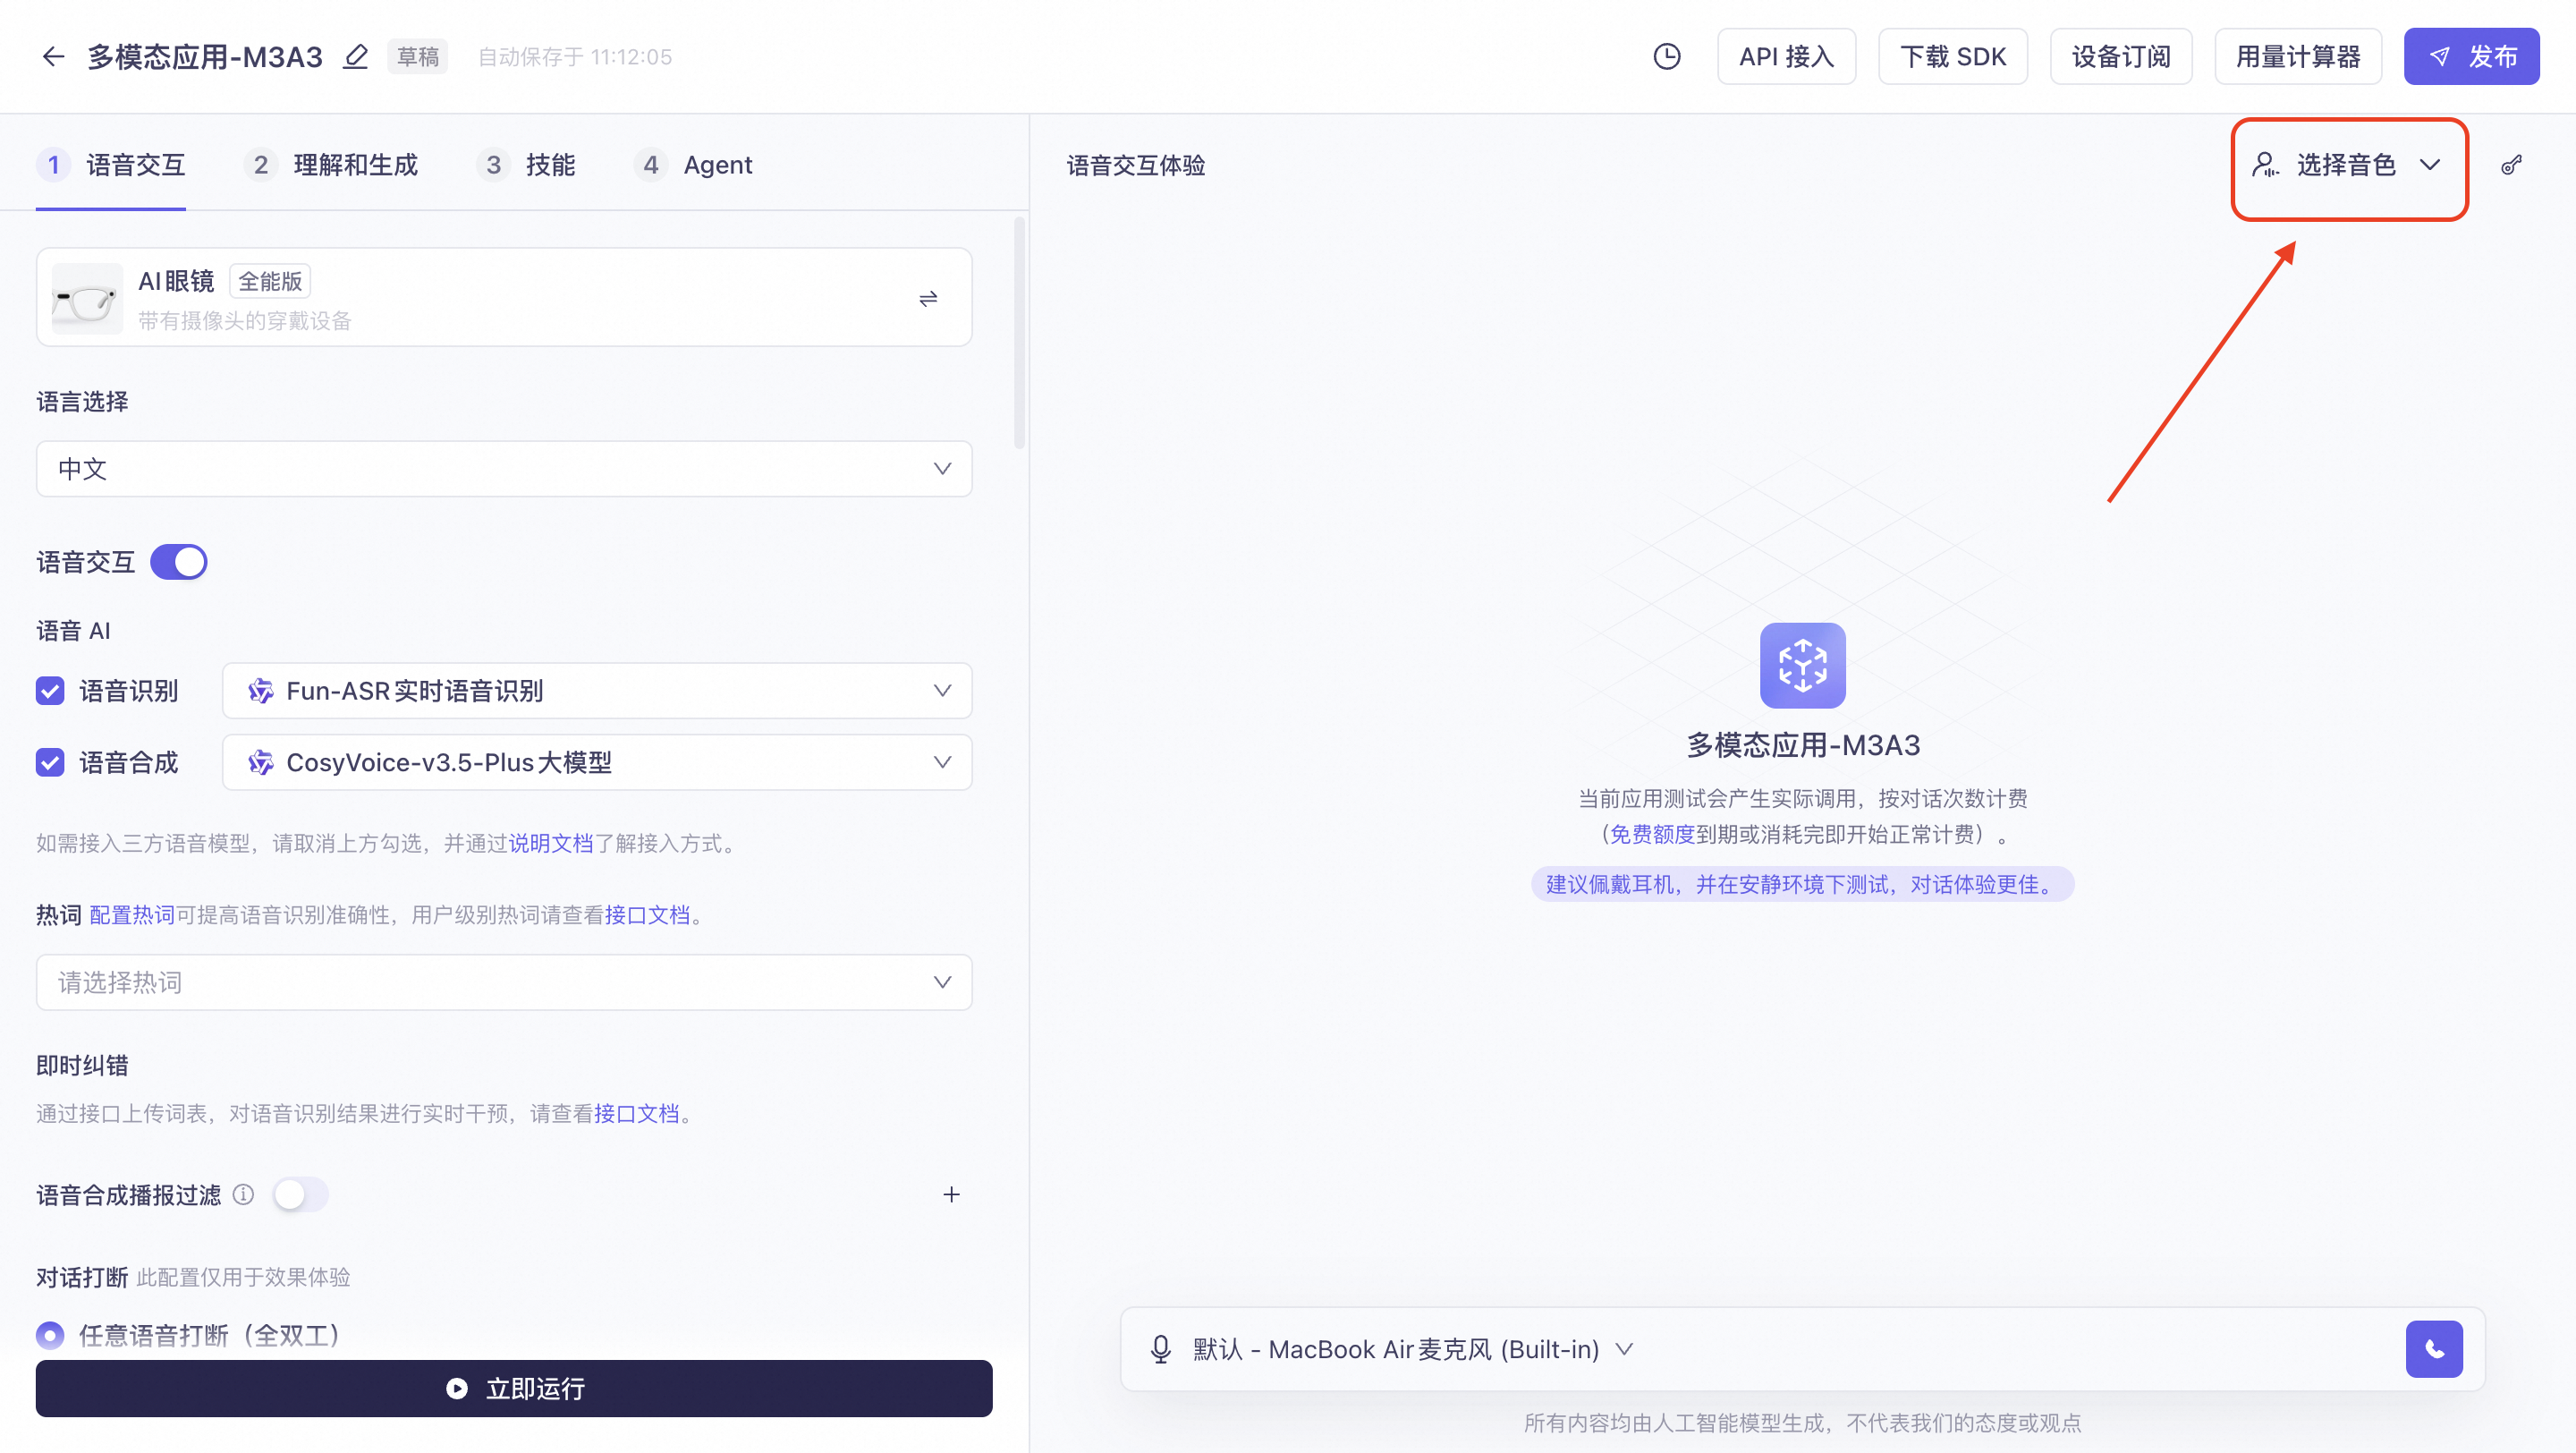
授权完成后,您可以点击应用体验区右上角的「选择音色」,在展开的面板中点击「设计音色」进行操作。
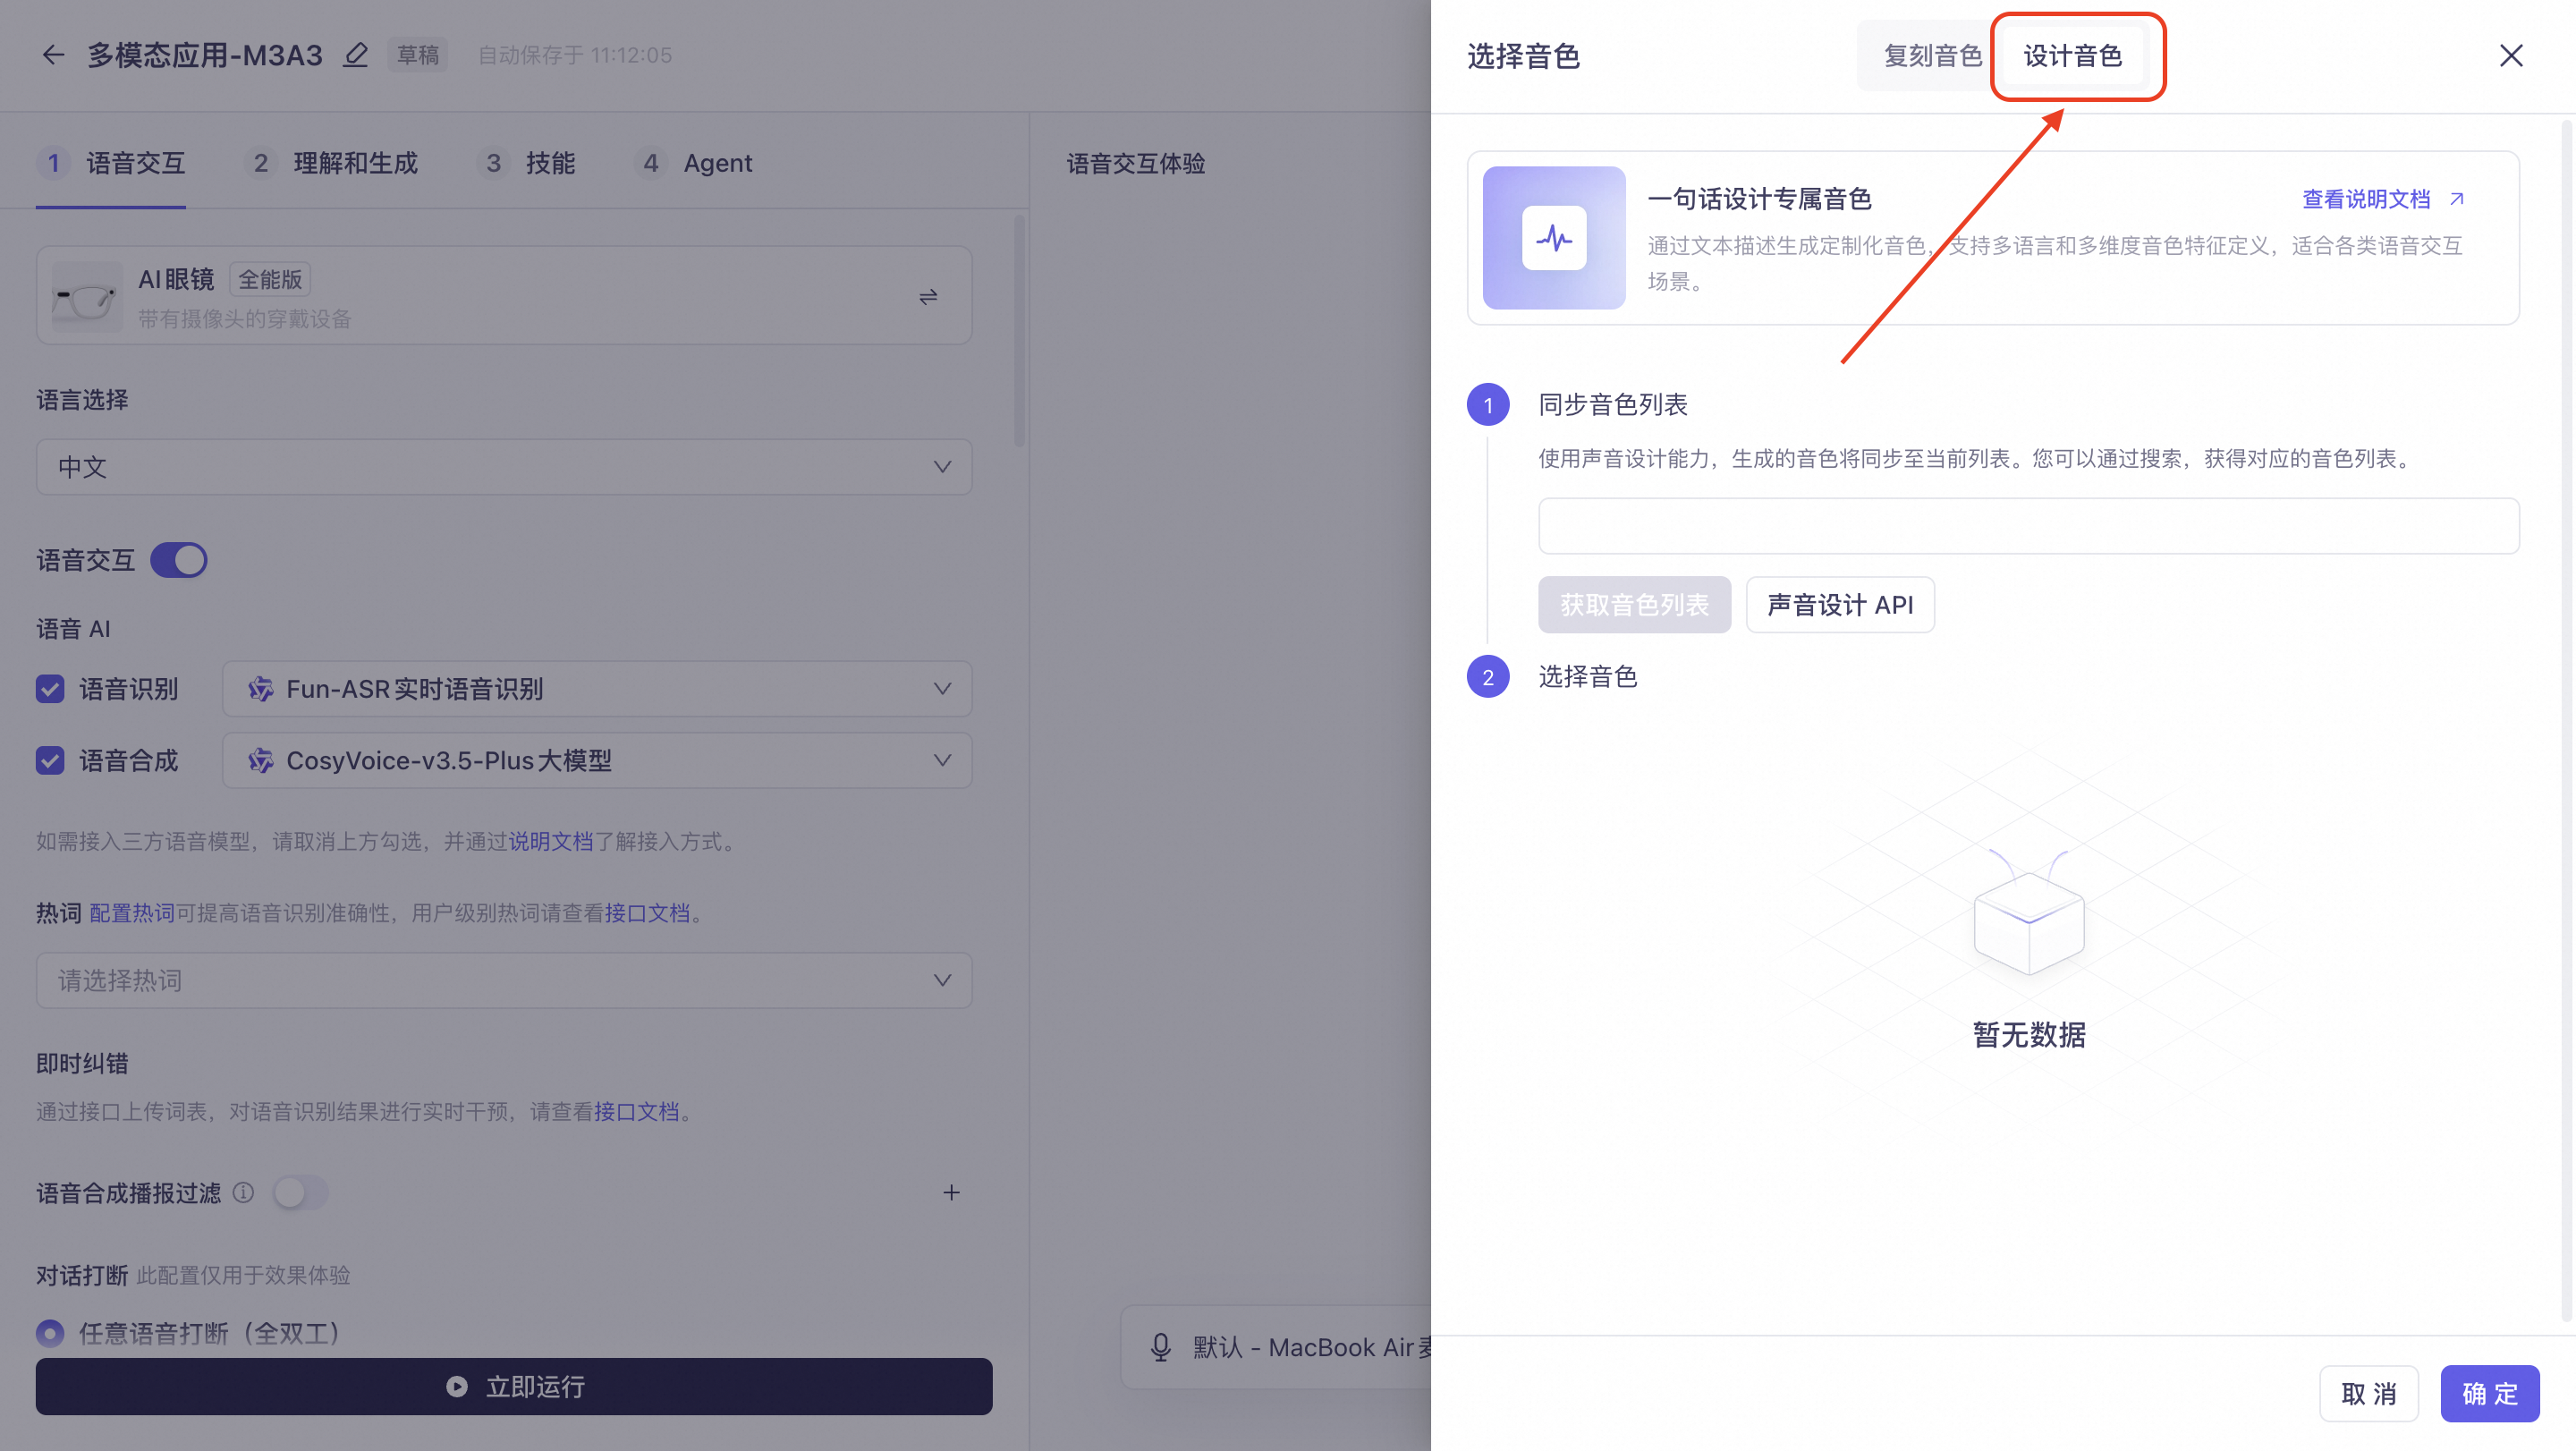
使用声音设计能力,生成的音色将会同步至当前列表,您可以通过搜索获取对应音色列表,然后选择需要的音色点击「确定」即可。
说明同步音色列表前,您需要先创建音色列表,创建音色列表请参考声音设计文档。